Я веду свой сайт на Тильде — как и большинство клиентских проектов. Удобно для лендингов, неудобно, когда страниц становится много: каждую публикацию приходится делать руками через редактор, кликая по кнопкам одну и ту же последовательность действий.
Я решил это автоматизировать. Ниже — не концепция и не «в теории можно», а разбор реально работающего скрипта: как устроен протокол, на чём он спотыкался и что в итоге получилось.
Забрать готовый скрипт бесплатно
Выложил его в своём Telegram-канале — можно скачать и адаптировать под свой сайт.
Забрать скрипт в Telegram
- У Tilda нет публичного API для публикации статей — только read-only методы, и то на платных тарифах.
- Реальный путь — перехватить внутренний протокол редактора через сетевой recon и воспроизвести его из кода.
- Публикация одной страницы — это три последовательных POST-запроса, которые нельзя выполнять параллельно.
- Headless-браузеры Tilda распознаёт и банит сессию — нужен видимый Chromium с живым человеком на капче при первом входе.
- Итог: скрипт публикует правки, создаёт новые страницы и грузит картинки за секунды вместо ручной рутины.
У Tilda нет API для публикации
Первое, что я проверил, — официальную документацию. У Tilda действительно есть API, но он не про то, что нужно.
Во-первых, доступ к нему открыт только на тарифах Business и выше — на Personal, на котором сидит мой сайт, раздела «API-интеграция» в настройках попросту нет. Во-вторых, даже на старших тарифах все семь методов API — getprojectslist, getprojectinfo, getpageslist, getpage, getpagefull, getpageexport, getpagefullexport — read-only. Ими можно прочитать страницу или выгрузить бэкап. Опубликовать или отредактировать блок кода — нельзя ни на одном тарифе.
Значит, единственный путь — автоматизировать сам браузер: открыть редактор так, как это делает живой человек, и заставить его выполнить те же действия программно.
Recon вместо документации
Раз официального протокола нет, пришлось составить свой — подсмотрев, что реально происходит в браузере при обычной ручной публикации.
Технику называют network recon: открываю редактор, вешаю на страницу перехватчики page.on('request') и page.on('response'), а дальше просто вручную один раз сохраняю и публикую блок — как обычно. Скрипт в фоне записывает каждый запрос: URL, метод, тело, заголовки, ответ сервера.
Из полученного лога можно вытащить настоящий протокол: какие поля обязательны, в каком порядке идут запросы, что сервер держит в сессии между шагами. Ловушка нашлась почти сразу: первая попытка recon обрезала тело запроса на 20 000 байт — и хвост с нужными полями попросту потерялся в логе. Пришлось переснимать с отдельным захватом последних 4 000 байт, иначе поля выглядели «отсутствующими», хотя браузер их отправлял.
Три запроса, которые публикуют страницу
Итоговый протокол оказался короче, чем можно было ожидать, — но с одним жёстким условием: три POST-запроса нужно слать строго последовательно, не параллельно. Сервер держит «какой блок сейчас редактируется» в состоянии сессии, которое выставляет первый запрос, — без него второй и третий не поймут, к какому блоку относятся.
// 1. Открыть блок на редактирование POST /page/edit/
comm=editrecordcontent&pageid=<id>&recordid=<id>&tab=content

// 2. Сохранить новый HTML POST /page/submit/
comm=saverecord&code=<html>&recordid=<id>&pageid=<id>
→ "OK" // 3. Опубликовать POST /page/publish/
comm=pagepublish&pageid=<id>&csrf=<token>&returnjson=yes
→ { "link": "https://<ваш-домен>/..." }
Ещё одна деталь, которую легко упустить: эти запросы нельзя слать «в лоб» через голый HTTP-клиент с скопированными куками — Tilda проверяет заголовки Referer и Origin и отвечает 404 даже с валидной сессией. Рабочий вариант — выполнять fetch(...) изнутри самой открытой страницы редактора через page.evaluate(), а не отдельным контекстом запросов Playwright. То есть браузер должен физически находиться на нужной странице в момент отправки.
Почему бот не может быть невидимым
Первая мысль — спрятать браузер в headless-режим, чтобы бот отрабатывал в фоне без окна. Не вышло: Tilda фингерпринтит сессию глубже, чем просто по User-Agent, и headless-Chromium получает в ответ HTML страницы логина вместо ожидаемого JSON — сервер тихо решает, что сессия не настоящая.
Поэтому headless:false — не опция, а жёсткое требование: браузер запускается видимым окном, как у живого пользователя.
Второе ограничение — капча. При первом входе может выскочить капча Яндекса (аккаунт авторизуется через Яндекс), и её решает человек в открывшемся окне браузера — распознавать её программно я не пытался, это разовая история на один вход. После первого успешного логина сессия сохраняется в файл и переиспользуется всеми последующими запусками, пока не истечёт.
Создание страниц с нуля
Публиковать правки существующих страниц — половина задачи. Вторая половина — создавать совсем новые, когда нужного slug ещё нет в проекте Тильды.
Решение — дублировать существующую страницу-донор (чистую, с одним HTML-блоком) через comm=dublicatepage, а затем задать ей новые адрес, заголовок и описание через comm=savepagesettings. Здесь нашлись два по-настоящему неприятных бага — оба молчаливые, без единой ошибки в ответе:
- Нужен «открывающий» запрос заранее.
savepagesettingsбез предварительногоgetpagesettingsв той же сессии возвращает 200 OK, но ничего не применяет — адрес и заголовок остаются от страницы-донора. - Нужны все поля формы, даже пустые. Пропуск поля
imgfile— и сервер в ответ пишет буквально «No imgfile!» вместо HTTP-ошибки, а изменения снова не сохраняются.
Отдельно скрипт принудительно сбрасывает nosearch в пустое значение на каждой созданной странице — продублированная страница может унаследовать от донора статус «не индексировать», и без явного сброса новая страница опубликуется невидимой для поисковиков без единого сигнала об ошибке.
Картинки и генерация обложек
Загрузка картинок работает похожим образом — отдельным протоколом, реверс-инжиниренным тем же способом. Редактор при открытии выставляет в window два значения: постоянный публичный ключ и одноразовый подписанный токен сессии. Дальше файл летит на upload.tildaapi.com как multipart/form-data и в ответ приходит постоянная ссылка на CDN — без ручного захода в «Хранилище», как раньше приходилось делать руками.
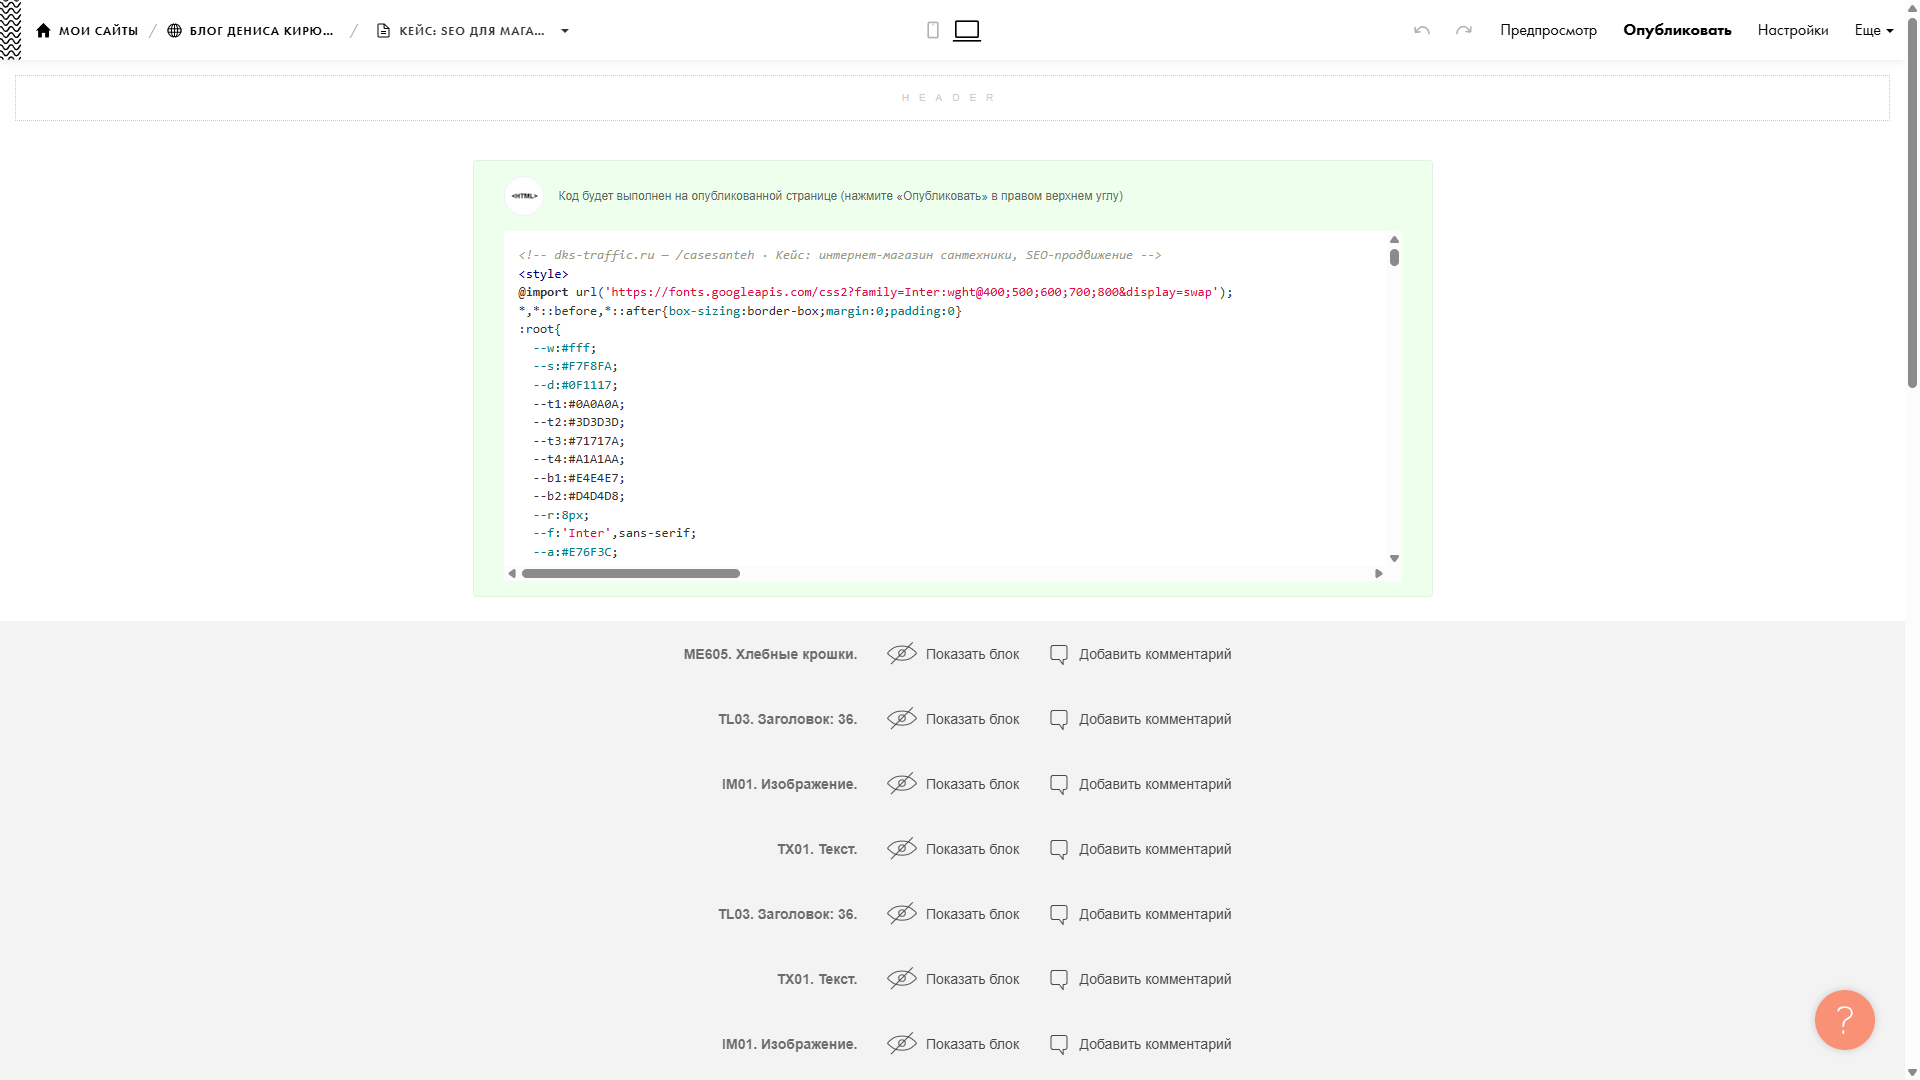
Поверх этого протокола я навесил генерацию картинок через API OpenAI: одна команда — и на выходе сразу готовая ссылка на CDN Тильды, без промежуточного скачивания и ручной заливки. Обложку и скриншот редактора для этой статьи, кстати, залил тот же самый скрипт.
Скрытый баг с хедером и футером
Этот баг стоил отдельного часа отладки. Логика Tilda: хедер и футер сайта не подключаются на лету единым инклюдом — они запекаются в HTML каждой конкретной страницы в момент её собственной публикации.
На практике это значит: поменяли меню на сайте, опубликовали только его — остальные тридцать страниц продолжат отдавать старый хедер, потому что их HTML собирался раньше и никто их не трогал.
Решение — отдельный скрипт, который проходит по всем живым страницам и переопубликовывает их без изменения контента, просто чтобы заново запечь актуальный общий хедер и футер во всех разом.
Что получилось в итоге
Сейчас скрипт умеет:
- Логиниться и хранить сессию между запусками
- Публиковать правки существующих страниц
- Создавать новые страницы по шаблону
- Загружать картинки напрямую на CDN
- Генерировать обложки через AI прямо в процессе
- Переопубликовывать весь сайт разом при обновлении хедера
Важная оговорка, которую не стоит замалчивать: это реверс-инжиниринг, а не официальный API. Tilda в любой момент может изменить внутренний формат запросов — и часть протокола перестанет работать без предупреждения. Отношусь к этому не как к готовому продукту, а как к рабочему инструменту, за которым нужно присматривать.
Зато прямо сейчас это разница между «публикация одной страницы — десять минут кликов» и «публикация — одна команда в терминале». Если у вас похожая история с Тильдой или любой другой платформой без нормального API — пишите, обсудим, что можно сделать.